GPT的发展历史
可以详细说下从GPT-1到GPT-4,有哪些变化,是如何发展的? – 白露未晞me的回答 – 知乎
https://www.zhihu.com/question/618248545/answer/2085709354997752347
太长不看版:GPT-1 把能力学进通用参数,GPT-2 和 GPT-3 逐步让任务进入提示与示例,GPT-3.5 通过人的反馈调整回答行为,GPT-4 与 GPT-4o 扩展了可处理的信息,o1 到 o3 让推理与工具选择接受训练,GPT-5 开始按问题分配计算,GPT-6 则继续提高长任务中的判断与行动能力。
然后具体展开讲讲吧。
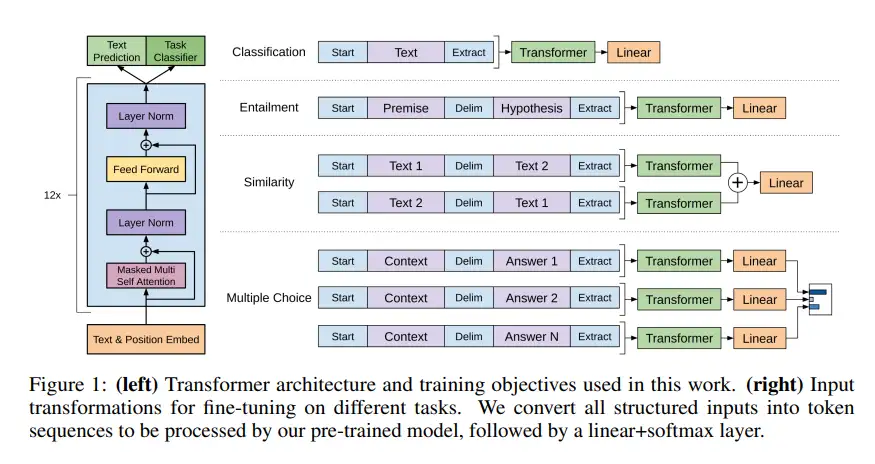
GPT-1 (2018) 其实主要解决了”通用能力从哪里来”这个问题。它先用 BooksCorpus 里的连续文本训练一个 12 层、约 1.17 亿参数的 decoder-only Transformer。训练时,模型只能看到当前位置之前的内容,目标就是预测下一个 token。经过这种大规模无监督预训练后,模型已经学到了一套可以复用的语言表示,因此同一组参数可以继续迁移到问答、文本分类、句子关系判断等不同任务上。为了让这些形式差异很大的任务都能交给同一个 Transformer 处理,GPT-1 会把每个任务重新表示成模型熟悉的序列输入。例如,文本分类可以直接输入一段文本,句子关系任务则把两个句子按固定格式拼接起来,问答任务也会把上下文和候选答案组织成一条序列。随后再利用各个任务自己的标注数据,对预训练模型进行监督微调。
因此,GPT-1 真正重要的地方在于,它证明了”先在大规模文本上学一套通用语言能力,再把这套能力迁移到具体任务”这条路线是可行的。只是到了这个阶段,每个下游任务仍然需要单独准备标注数据,并分别进行微调。
GPT-2 (2019) 接着把问题往前推了一步:如果预训练文本本身已经包含大量不同任务的示范,模型能不能在预训练过程中顺带学会这些任务,并在测试时只靠上下文判断”现在要做什么”?
它沿用了 GPT-1 的 decoder-only Transformer,并把最大模型扩展到 48 层、约 15 亿参数;训练数据也从 BooksCorpus 换成了 WebText,一个经过筛选、去重后包含约 800 万篇网页、40 GB 文本的数据集。为了让语言模型能够直接处理尽可能广泛的字符串,GPT-2 还采用了 byte-level BPE,并把上下文长度从 GPT-1 的 512 token 提高到 1024 token。
作为对比,GPT-1 做完语言模型预训练以后,还要针对分类、问答等任务分别准备标注数据,再更新参数进行微调;GPT-2 则开始测试另一种可能:参数保持不动,只通过输入上下文告诉模型当前正在进行什么任务。论文把这种方式系统地用在了阅读理解、摘要、翻译和问答等任务上,而且不再为这些任务进行额外训练。
不过这里的”告诉模型任务”还很原始,也和今天成熟的 instruction prompting 有很大距离。做摘要时,研究者在文章末尾加上 TL;DR:;做英法翻译时,他们先在上下文中放几组 English sentence = French sentence 的例子,再留下一个待完成的英文句子;做事实问答时,同样先放一些问答对,让模型推断接下来应该生成一个简短答案。也就是说,GPT-2 已经出现了后来 prompt 和 in-context learning 的雏形,但更多依赖格式、示例和自然文本中的模式,而不是今天这种明确写出”请把下面这段话翻译成法语”的指令。
至于实验结果方面,就不尽如人意了,随着模型从 117M 一路扩大到 1.5B,许多 zero-shot 任务的性能持续提高,说明这些能力确实会随着模型容量增强而逐渐出现;但当时距离真正实用还有很远。比如摘要虽然已经能生成”像摘要”的文本,ROUGE 指标却只勉强超过随机抽取三句话的基线;开放域问答的正确率也只有 4.1%。
所以简单总结一下从 GPT-1 到 GPT-2,GPT-1 证明了”一个模型可以先预训练,再分别迁移到很多任务”,GPT-2 则开始证明”足够大的语言模型可能在预训练本身就学到很多任务,而具体要调用哪一种能力,可以由输入上下文来决定”。
GPT-3 (2020) 基本就是把 GPT-2 这条路推得更远。最大版本扩展到 1750 亿参数、96 层,上下文长度增加到 2048 token,训练量达到 3000 亿 token;模型仍然沿用自回归 Transformer,只在不同层之间交替使用 dense attention 和 locally banded sparse attention。训练数据也扩大到了以 Common Crawl 为主体的混合语料,经过过滤、去重后,再混入 WebText2、Books 和 Wikipedia,并提高高质量语料的采样权重。
GPT-3 还把 GPT-2 已经出现的 zero-shot 用法进一步系统化成 zero-shot、one-shot 和 few-shot。few-shot 时,只需要在上下文里放几个”输入 → 输出”的例子,模型就能照着这个模式处理新的输入,整个过程不做梯度更新,也不修改参数。论文把这种依靠当前上下文临时适应任务的能力称为 in-context learning,而且这种能力会随着模型规模增大而明显增强。
但问题也随之暴露出来了。GPT-3 的训练目标始终是预测下一个 token,它可以学会很多任务,也可以模仿很多文本形式,但”接下来最像什么”和”用户真正希望它怎么回答”并不总是一回事。
于是到了 2022 年前后,重点开始转向后训练。InstructGPT 先用人工编写的高质量回答做监督微调,再让标注者比较模型生成的多个候选答案,把这些偏好训练成一个奖励模型;随后由这个奖励模型给模型输出打分,并通过 PPO 继续优化生成策略。整个流程把”人更喜欢什么样的回答”直接变成了训练信号,也把 GPT 从单纯的语言建模进一步推向了 instruction following。
实验结果方面,值得一提的是在所测试的用户提示上,标注者更喜欢 13 亿参数的 InstructGPT 的回答,而不是原始 1750 亿参数的 GPT-3。这个结果说明模型规模决定了很大一部分能力上限,但这些能力最后以什么方式表现出来,后训练同样关键。
再往后,OpenAI 没有专门为 GPT-3.5 发表一篇类似 GPT-3 的完整论文,而是把 2022 年前后的一批改进模型统称为 GPT-3.5 (譬如code-davinci-002、text-davinci-002、text-davinci-003)。它延续了前面的预训练和后训练路线,并进一步把代码能力纳入其中。2022 年底发布的 ChatGPT 就是在 GPT-3.5 基础上继续做对话式 RLHF,把单轮的 instruction following 推到了多轮对话。
到了 GPT-4 (2023),模型开始从纯文本走向了多模态,除了文字,模型也能直接接收图像并结合文本一起处理了。底层仍然沿用 Transformer 和自回归生成,但 OpenAI 从这一代开始不再公开参数量、具体结构和完整训练配方了。
因此 GPT-4 的技术报告并没有再像 GPT-3 那样把重点放在模型规模和结构细节上,而是花了不少篇幅讨论大模型训练本身能不能被提前预测。OpenAI 先用规模小得多的训练实验拟合 scaling law,再预测 GPT-4 训练完成后在独立代码测试集上的 loss,实际结果和预测非常接近;类似的方法也被拿来预测 HumanEval 上的代码表现。随着训练成本继续上升,如何用小规模实验判断大模型最终会训练到什么水平,开始变成很实际的工程问题。
同一年,GPT-4 还开始更系统地接入外部工具。function calling 允许模型根据函数定义生成结构化参数,再由外部程序真正执行查询、计算或 API 调用,并把结果返回给模型继续生成。这样模型能做的事情开始从”根据已有上下文回答”扩展到了”主动调用外部能力完成任务”。
GPT-4 接入图像之后,2024 年的 GPT-4o 又把多模态往前推了一层。此前 ChatGPT 的语音模式实际上是”语音转文字 → GPT 回答 → 文字转语音”的三段流水线,GPT-4o 则把文本、视觉和音频放进同一个模型里端到端训练。这样语气、背景声和多位说话者这些信息不必先被压成文字,语音响应延迟也从原来的数秒降到了平均约 320 毫秒。
同年,o1 又把一种新的计算资源摆到了台面上:回答前的思考时间。它通过大规模强化学习训练模型形成更长的推理过程,在这个过程中拆分步骤、发现并修正错误,当前思路走不通时再换一种方法。实验里,增加训练阶段的强化学习计算量,以及让模型在推理时花更多计算继续思考,都会提高困难任务上的表现。到了 2025 年的 o3,这条推理路线又和前面的工具调用合到了一起。模型通过强化学习,学会在推理过程中判断什么时候搜索网页、什么时候运行 Python,以及拿到工具结果以后下一步该怎么做。
到了 GPT-5(2025),GPT 主线和 o 系列的 reasoning 路线开始合到一起。ChatGPT 里的 GPT-5 实际上是一套统一系统:普通问题交给更快的模型,困难问题转给更深的 reasoning 模型,再由一个实时 router 根据任务复杂度、工具需求和用户意图决定走哪条路径。这样一来,系统可以根据任务需要,自动选择快速回答或投入更多计算进行深度推理。
后面的 GPT-5.6 又继续往长任务和工具使用推进。模型可以直接写并运行一些轻量程序,用它们协调多个工具、过滤中间结果,再决定下一步做什么,不必把每一次工具返回都重新塞回上下文里。到这里,推理已经越来越像一个持续执行的过程,而不只是生成一段更长的思维链。
GPT-6 Astra(2026) 又把这条路线往前推了一步,重点放到了 computer use 和长时间的端到端工作上。它的 API 上下文窗口为 105 万 token,同时针对浏览器操作、软件工程、研究和专业工作做了更强的训练。模型可以在一项任务里持续浏览、运行代码、操作软件并根据结果修改后续行动,推理、工具调用和实际操作开始真正连成一条完整的执行链。