λ演算-简单介绍lambda演算的基本定义以及操作
0. 前言
我们从数学上证明了, 剪贴和粘贴是图灵完备的, 所以, 大胆抄代码吧! 该文章适合初学者,有一定的数学基础和计算机基础的非科班水平就够了。 该文章适合初步了解lambda演算的人。 该文章不适合已经熟悉lambda演算,想深度学习精通lambda的人。因为它太基础了。lambda演算有个特色,就是一下午学会语法,剩下10年都可以开始学宏了。所以需要深度学习,请网上找lambda语言的宏,然后慢慢拼接高级用法吧。 该文章不适合专门研究TCS领域的人去进一步学习,因为文中定义和涉及到的证明可能并不严谨。但是我非常欢迎你们来指出我文章中可能出现的小错误,因为只有你们,这篇文章才能越来越完善。感谢评论区大家的贡献。
λ演算(Lambda Calculus) 是一套从数学逻辑中发展, 以变量绑定和替换的规则, 来研究函数如何抽象化定义, 函数如何被应用以及递归的形式系统.
最早是忘了在哪里, 大概就是知乎吧, 某天吃午饭的时候刷出来的. 所以很早就知道有一个图灵机的等价系统, 但是运行方式和图灵机看起来非常不一样. 之前就一直有想了解的想法, 然而收藏到收藏集后一直就处于吃灰状态. 现在正好保研了, 没啥事情, 闲来无事就学习一个. 发现这个东西还挺有意思的.
网上国内外到处都有介绍λ演算的文章, 但是要么问题百出, 要么晦涩难懂. 我争取用我认为通俗易懂的方式介绍下这个东西, 也权当记笔记了.
我之前的一篇文章介绍了另一种图灵完备的图灵机, 叫BrainFǔck机.
NGC13009:Brain Fuck 编译器/解释器/虚拟机的实现
很离谱.
而这篇文章介绍的λ演算也是一种图灵完备的东西. 有兴趣的人尝试写一个λ演算的解释器/编译器吧, 高手可以试下BF和λ之间的转换. (把一种语言编译为另一种语言)
本文想到哪写哪, 故较为啰嗦. 限于水平有限, 出现错误属实正常, 直接在评论区发布问题, 立刻整改.
修改记录: 最早是2022年9月16开始写的。 后来修改过几次小细节 2024年9月15日添加了一些内容
1. 图灵机(Turing Machine)与图灵完备性问题
1.1. 可计算问题与不可计算问题: 图灵机能处理谁?
首先, 数学家将问题分为了两大类, 具体来讲是这两大类:
定义:
- 可计算问题 (可以被 图灵机 在 有限步骤内 得到 确定结果 的问题)
- 不可计算问题(图灵机使用超过无限步骤次数才能解决的问题)
听起来像是废话. 但是这个定义至少明确了什么问题是可以使用算法实现的. 换而言之, 不可计算问题压根不可能用简单的算法实现, 必然需要超过图灵机的计算能力之外的方法才行.
然而,我们现在还不知道什么是图灵机。另外”无限次“步骤是什么玩意?如果你了解过一些集合论,实分析的数学基础的话,你就知道无限次数其实也是分等级的。但是我们先不管集合论上面的事情,因为这不是本文的重点。所以先给个简单的介绍:
定义:只要一个问题确定后,能在给定的 \(n\in \mathbb N\) 次内得到确定的输出,那么这就是一个在有限步骤内得到确定结果的问题。否则就是无限次才能解决的问题。
比如,”使用循环相加的方法确定 \(\displaystyle\sum_{n=1}^{+\infty}\frac{1}{n^2}\) 的值“就不可能在有限次完成。但是假如我们的问题是”使用循环相加的方法确定 \(\displaystyle\sum_{n=1}^{+\infty}\frac{1}{n^2}\) 的值使之误差与真实值小于 \(1\times10^{-6}\) “就是有限步骤内可解决的了。因为我们知道这玩意是收敛的,并且随着n的增大,误差会越来越小。所以只需要看什么时候迭代n的变化量小于给定的 \(1\times10^{-6}\) 就可以退出计算了,所以是可以在有限步骤内完成的算法。注意这个定义和图灵机的定义无关。
定义:图灵机是一种抽象计算模型,它用来定义什么是可计算的。图灵机的严格定义是通过数学符号来描述它的各个组成部分和行为。可以把图灵机看作一个七元组,分别为 \(Q\) 有限状态集合, \(\Sigma\) 存储字母表, \(\Gamma\) 处理字母表, \(\delta\) 状态转移函数, \(q_0\) 初始状态, \(q_a\) 接受状态, \(q_r\) 拒绝状态。写成一个整体就是
\[\begin{aligned}T&=(Q,\Sigma,\Gamma,\delta,q_0,q_a,q_r)\\ s.t. \Sigma&\subseteq\Gamma;\delta:Q\times\Gamma\to Q\times\Gamma\times\{L,R\};q_{…}\in Q\end{aligned}\]
看不懂符号没关系,因为我用符号占用版面一是为了让大片文字分开点,更美观;二是为了强调,图灵机是数学模型,而不是什么现实存在的机器。网上被写烂的”纸袋模型“容易给人一种主观的感觉,认为图灵机是一个打孔机器。然而事实上,图灵机是一个数学模型。
所以我们从数学模型的角度去解释它,这样更加不容易被误解,陷入考虑现实如何实现的细枝末节上:
为了方便理解,我们先不管图灵机内部如何,我们先将其当作一个黑箱。那么这个黑箱有输入和输出,并且输入输出处于一个地方,我们不妨称这个地方叫“存储空间”。
存储空间可以存储一些“符号”,在现实中,这些符号可能是高低电平,使用0和1表示,也可以是ASCII码之类的。现实中的符号会被人赋予意义。但是我们不考虑现实,我们现在只考虑数学。在数学中,符号没有任何实际的作用,我们只关心如何区分符号,并让图灵机这个黑箱只会按照符号进行特定的操作。
符号有两类,一类告诉图灵机怎么做,一类是被图灵机处理的信息。称之为“指令”和“数据”。很多个指令串起来就构成了“程序”。数据有不同的类型和结构,但是对于图灵机来说无所谓,图灵机只需要按照程序去处理一个个数据符号就行。
如果有两个存储空间,一个存储空间上的符号告诉图灵机该怎么操作另一个存储空间上的符号,那么这个架构叫做“哈佛架构”。如果只有一个存储空间,两类符号共存在一起,图灵机按照特定模式去处理,从而正确的区分符号和数据,那么这个叫“冯诺依曼架构”。
我们暂时不讨论计算机那些工科的事情,继续讨论数学。我们发现,事实上程序和数据都是由符号构成的。
我们现在开始考虑图灵机这个黑箱内部发生了什么。图灵机在制定处理符号的规则时,似乎没必要非得把指令和数据区分开哦。那这样就简单了。
现在再回头看图灵机的公式定义:
图灵机定义:
\[\begin{aligned}T&=(Q,\Sigma,\Gamma,\delta,q_0,q_a,q_r)\\ s.t. \Sigma&\subseteq\Gamma;\delta:Q\times\Gamma\to Q\times\Gamma\times\{L,R\};q_{…}\in Q\end{aligned}\]
其中分别为 \(Q\) 有限状态集合, \(\Sigma\) 存储字母表, \(\Gamma\) 处理字母表, \(\delta\) 状态转移函数(注意是函数 (function,作用),而其他字母都表示的是符号的集合,只有 \(\delta\) 表示的是符号之间的作用关系,这是图灵机比较重要的核心), \(q_0\in Q\) 初始状态, \(q_a\in Q\) 接受状态, \(q_r\in Q\) 拒绝状态。
是不是就明白了?本质上,图灵机就是一个将符号不断变换的机器。它有一个内部状态,每个步骤, \(\delta\) 会传入当前存储空间上的一个符号,然后根据当前状态,判断该怎么在存储空间的哪个位置读写什么符号,以及怎么改变自身的状态。如果想更容易理解,那么把状态空间和符号空间都看做一个有限大小的集合就行了(集合的大小指的是集合元素的数目)。能看这篇文章,大概率没有什么TCS基础,但是高中的集合和函数的基础肯定是有的吧?注意图灵机的定义也是独立的。
然后我们看可计算问题的定义:
定义: 可计算问题(可以被图灵机在有限步骤内得到确定结果的问题) 不可计算问题(图灵机使用超过无限步骤次数才能解决的问题)
是不是就搞明白了。
比如举个例子:
属于可计算问题的:
- 加法与乘法运算等
- 函数
\[f(x)=x^2\]
的值 3. 排列组合问题 4. Ackermann函数的值, 即
\[A(m,n)=\left\{\begin{array}{lll} A(0, n) & =n+1 & s.t.\;\; n \geq 0 \\ A(m+1,0) & =A(m, 1) & s.t.\;\; m \geq 0 \\ A(m+1, n+1) & =A(m, A(m+1, n)) & s.t.\;\;m, n \geq 0 \end{array} \right.\]
虽然这东西增长率达到了 \(FGH_{\omega}\) ,但是它本质上还是可以在有限次步骤完成计算的,只不过需要的状态空间和符号空间可能也”比较大“就是了。或者拿知乎日经的”葛立恒函数“或者”TREE(x)“去考虑,都可以。
属于不可计算问题的:
- 今天吃什么?(没有严格的符号图灵机表述的问题定义)
- 停机问题 :设想有一个程序,输入另一个程序和它的输入。问题是,能否确定这个程序是否会最终停止,还是会一直运行下去?图灵证明,没有一个通用的算法可以解决这个问题。(注意是数学下的严格证明)
- 图灵归约问题 (Turing Reduction Problem):这个问题问的是,给定两个图灵机 \(M_1\) 和 \(M_2\) ,能否构造一个算法确定 \( M_1 \) 是否可以通过某种方式将输入归约为 \(M_2\) 能处理的形式?虽然部分特定情况下可以解,但没有一个通用算法能解决所有图灵机的归约问题。
- 语言归属问题 :这个语言指的是TCS中的”语言“。而语言归属问题指的是给定任意语句,是否可以确定该语句是否属于给定的语言。由于这个问题中的语言可以是停机问题的等价语言,所以显然。
不可计算问题感觉都是没有通用算法去解决的问题,发现了吗?
1.2. 算法的复杂度
定义: 如果一个算法的时间复杂度(往往也意味着空间复杂度)是多项式级别的, 那么称这个算法是P类问题. (多项式的英语是polynomial)
定义:时间复杂度就是数据量与算法消耗的运算次数的大概量级关系, 空间复杂度指的是消耗的内存空间.
定义: 拥有非多项式时间复杂度但是验证的时候复杂度可以是多项式复杂度的算法是NP问题. (non-polynomial)
定义:一个问题被称为NP-hard,如果它满足以下条件:若有一个多项式时间算法能够解决该问题,那么所有NP问题也可以在多项式时间内得到解决。也就是说,NP-hard问题的难度至少和任何NP问题一样高,可能更难,甚至不一定属于NP类问题(即不一定在多项式时间内验证解)。这个我也不太清楚什么意思。书上抄的。
一般来说我们希望问题拥有多项式复杂度, 这样基本上可以运算的很快, 但是有些算法复杂度过高, 复杂度增长率太大, 一不留神给多一点数据, 就要算到天荒地老了.
比如,NP问题:TSP旅行者问题:
旅行者问题:假如有个旅行者好久没上号了,今天上号发现地图都开到纳塔了,但是它只开了个初始传送锚点。旅行者网上搜了一大堆攻略,确定了锚点和七天神像两两之间的时间成本。旅行者现在想知道,怎么样的一个开锚点和七天神像的路径,是时间成本最低的?
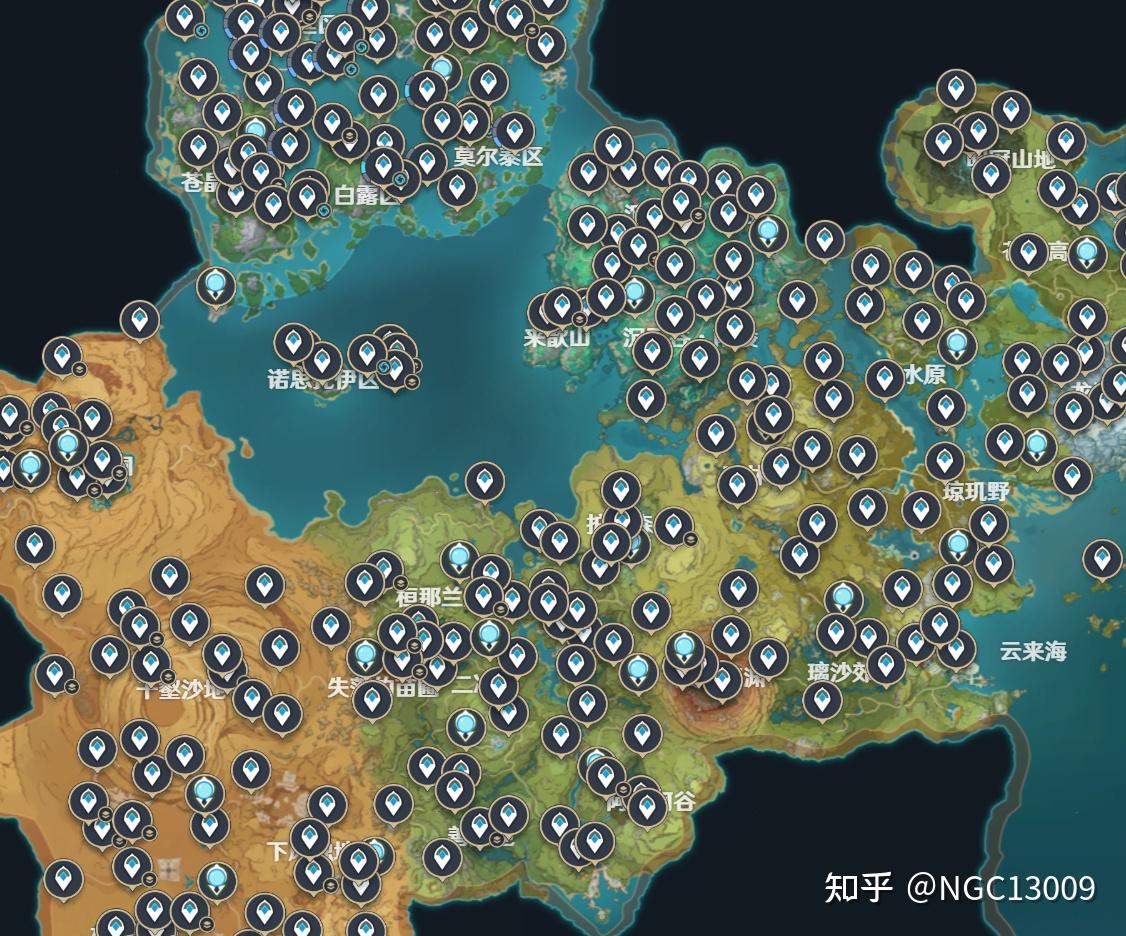
大多数教材上面的插图,路径点都太少了,无法突出TSP问题的计算复杂度是怎么爆炸的
暴力搜索算法的复杂度: \(o(n!)\) ,其中n是路径点的数目。可以看出来现在我们的米哈游原神有几百个传送点,那么暴力搜索一次的成本是阶乘增长的。我们知道阶乘的公式是
\[x!= \Gamma\left( x \right)=\int_{t=0}^{+\infty}t^{x-1}e^{-t}dt\]
所以暴力搜索的算法显然是NP的。
1.3. 算法的可解性
定义: 如果一个算法的复杂度有上界, 即给定数据的大小和量, 总是可以确定这个算法的时空需求小于某给定数, 那么这个算法是可解的.
定义: 反之认为算法是不可解的, 也就是可能有趋于无穷大的复杂度, 那么理论上就没法计算. 因为图灵机只能处理有限复杂度的问题.
定理: 可计算问题不一定总是有解.
换而言之, 总是存在一类可计算问题, 他们是没法用算法在有上界的时间界限和空间界限内解决的.
举个例子, FFT算法接收
\[2^N\]
个复数数据, 最多进行
\[N\log N\]
次加法以及
\[\frac{1}{2}N\log N\]
次乘法, 占用同等数量的空间.
有的算法的复杂度吓人, 基本上不能在电脑上运行, 比如定义的 Ackermann(阿克曼)函数:
\[A(m,n)=\left\{\begin{array}{lll} A(0, n) & =n+1 & s.t.\;\; n \geq 0 \\ A(m+1,0) & =A(m, 1) & s.t.\;\; m \geq 0 \\ A(m+1, n+1) & =A(m, A(m+1, n)) & s.t.\;\;m, n \geq 0 \end{array} \right.\]
这个函数是递归的, 接收两个自然数,输出一个自然数, 而且不是发散的, 肯定是一个具体的数, 所以是可计算问题.
但是这个函数在 \(A(5,0)\) 的时候基本就不能用普通的计算机去计算了, \(A(7,0)\) 就可能永远也计算不出来了…..因为其信息熵可能大于宇宙的信息熵.
可是, 该函数却属于可解的可计算问题. 因为其存在一个算法的复杂度上限(一般也就记为阿克曼函数, 因为太大不方便用多项式表示), 也就是说可以给定自然数 \(N\) 和 \(n\) 使得 \(\mathcal{O}(A(n,0))<N\) .
但是图灵机停机问题却是一个不存在有限复杂度的算法问题, 也就是说这个问题本身不存在固定复杂度的可解算法.
该算法最简单的实现是将程序跑一遍, 但是还是很难看出来算法是否会运行到停止,因为一些程序事实上是死循环, 然后Alan Turing(艾伦·图灵)在1936年证明了该问题不存在通用算法, 使用的是反证法. 留作课后习题.
一个可计算问题是否可解, 只由其本身固有属性决定.
有些人提到了,死循环可能被编译器发现并提示,那么是不是一个反例呢?那是你没见过卡死编译器的程序源代码。
1.4. 图灵机
前文已经给出了图灵机的定义,现在再说第三遍:
图灵机定义:
\[\begin{aligned}T&=(Q,\Sigma,\Gamma,\delta,q_0,q_a,q_r)\\ s.t. \Sigma&\subseteq\Gamma;\delta:Q\times\Gamma\to Q\times\Gamma\times\{L,R\};q_{…}\in Q\end{aligned}\]
其中分别为 \(Q\) 有限状态集合, \(\Sigma\) 存储字母表, \(\Gamma\) 处理字母表, \(\delta\) 状态转移函数(注意是函数 (function,作用),而其他字母都表示的是符号的集合,只有 \(\delta\) 表示的是符号之间的作用关系,这是图灵机比较重要的核心), \(q_0\in Q\) 初始状态, \(q_a\in Q\) 接受状态, \(q_r\in Q\) 拒绝状态。
要进一步详细介绍图灵机的话, 我想先介绍最早的”机械确定论”.
机械决定论是把物质及其机械运动作为决定性的因素, 简单地把拉普拉斯的动力学决定论从自然界直接推广和运用于社会历史领域. 简单的说就是用力学原理解释所有事物本质. 目前我们认为这个是错误的思想. 可能读者会听过”拉普拉斯妖”这个概念, 很有趣, 一大堆科幻小说基于此(比如刘慈欣的”镜子”).
现在的人陷入了另一个牛角尖, 就是是否所有问题都能用算法解决?
我们刚才已经知道了只有一部分问题是可以使用算法解决的. 所以当下的工作自然就是研究:
- 哪些问题是算法可解的?
- 算法可解的问题怎么解决?
- 算法可解的问题的解决方式有什么共性?
第一个问题交给数学家, 已经基本明确了一些东西. 第二个问题交给程序员写程序去.
第三个问题, 我们已经发现了, 算法可解的问题确实有共性, 就是都能用图灵机或图灵机等价机器解决, 而且他们相互可以规约, 等会解释什么是规约.
定义: 如果某种东西, 比如状态机, 比如图灵机, 比如λ演算, 比如元胞自动机, 比如我的电脑….它可以完成所有图灵机完成的算法, 那么它是图灵完备的.
因为是 Alan Mathison Turing 提出的, 所以叫 Turing Machine.
定理: 图灵完备的东西可以相互规约, 也就是可以相互化简到另一种图灵完备的等效图灵机.
用人话来说就是, 举个例子, 元胞自动机和BF机都是图灵完备的, 那么任何可计算问题的算法应该都是可以运行在它两上面的. 比如FFT算法就一定可以用BF实现, 当然也可以用元胞自动机实现.
知识点:MineCraft也是图灵完备的.
知识点:λ演算是图灵完备的.
已经有人证明过这些了. 甚至已经有人实现了一些东西….
可能规约这个词太晦涩难懂, 我感觉它的另一个意思其实就是虚拟化的概念. 也就是说, 图灵完备的机器之间可以互相虚拟化, 我用程序算法实现一个你的虚拟机, 你也可以反着来. 你能解决的算法我也可以.
注意: “规约”这个词在不同的语境下含义不一样, 数学上有一种说法是”规约是推导的逆过程”, 换一种解释就是常见的”注意到……../显然………/易知”之类的凑项的感觉, 在编译原理里, 表示一种文法规则, 这里的λ演算的英文资料中用的单词Statute直接翻译过来就是规约, 我也没有特别准确的理解这个Statute是啥玩意…..暂且领悟成”相互兼容”的意思吧. 但是理论上只有”可以互相规约”才能称为”相互兼容”
有没有图灵不完备的机器? 有.
知识点:HNN网络不是图灵完备的, BP前向神经网络也不是图灵完备的..
这东西不是图灵完备的
也就是说很多人天天吹的深度学习, 其实能解决的问题还不一定比图灵机多.
讲了这么多p话只是为了引入图灵机的概念, 然后告诉大家λ演算也是图灵完备的. 那么说这么多p话的用处是什么? 强调λ演算是图灵完备的啊! 也就是说所有算法都能用λ演算实现! 包括加法乘法减法一直到卷积神经网络! 加上中断和外设之后, 甚至能跑一个虚拟机运行Windows系统! 当然有没有人实现就不是我们的事情了.
关于λ演算是图灵完备的证明, 就不在文章写了. 本文重点讲lambda演算的规则和能实现的一些简单算法.
2. λ演算
图灵机系统(代表作 BrainFǔck机,这个是我见过的最简洁的图灵机)和λ演算之间的关系类似于对偶的关系。
这个对偶怎么去品呢?比如有一个东西, \(y=f(x)\) ,假如我们固定函数 \(f\) ,改变 \(x\) ,那么输出 \(y\) 会跟着改变。那么假设我们可以构造一个很好的数据信息到 \(x\) 的映射作为输入,然后设计合理的函数 \(f\) ,把输入当作 \(x\) ,那么是不是就能处理输入得到输出了?设计函数 \(f\) 实际上就是设计图灵机。
而λ演算,则是固定 \(x\) ,将函数 \(f\) 当作输入,不同的函数 \(f\) 会得到不同的输出。那么假设我们可以构造一个很好的数据信息到 \(f\) 的映射作为输入,然后设计合理的 \(x\) ,把输入当作 \(f\) ,是不是也能得到很好的输出?
显然,把数据信息映射到 \(f\) 还是 \(x\) 上,都是可以的,虽然大部分人没见过数据还能往函数上进行映射。。。。但是显然没问题啊!
图灵机就是构造输入到 \(x\) 的映射,构造 \(f\) 作为处理的方法。事实上图灵机没有显式的函数 \(f\) ,它用符号关系作为函数映射操作。这个很好理解,现在小学生都知道,计算机实际上就是二进制门电路构成的,所谓函数,实际上也只是一些01构成的模拟操作了。那么再数学上,是不是也很好理解?
而λ演算,就是构造输入到 \(f\) 的映射,构造 \(x\) 作为处理的方法。事实上λ演算没有显式的数据或者 \(x\) ,它的”数据“和函数其实都是函数!!也就是说,λ演算中,压根没有除了函数以外的东西,所有东西都是函数。万物皆函数,λ演算的世界,变量,参数,代数,甚至几何拓扑关系,都是函数。一群函数,不需要任何传入的自变量,他们自己就能图灵完备,模拟出整个宇宙的东西。
λ演算最早是 Alonzo Church (邱奇) 发明的, 甚至比图灵机理论提出的还早, 所以探讨, 如果当年计算机走上了λ演算的邪门歪道, 现在的计算机科学与技术会是什么样子, 应该也会很有意思的吧? 一个良好的科幻小说题材. 可惜λ演算虽然更贴近数学, 但是实在是不能和硬件结合密切, 故而限制了它的发展.
关于为什么叫λ稍后会解释.
先得讲清楚几个东西, 要不然不好说. λ演算的定义在 2.4 .
2.1. 中缀表达式
众所周知, 算式分为运算符 (operator) 和操作数 (Operands) 两个部分.
定义: 如果运算符是在中间放着那么叫中缀表达式. 比如
3+5
6-7
2.3×5/8
都是属于中缀表达式.
人类发展的时候默认发明了中缀表达式, 因为方便人类理解. 但是计算机很不容易理解这些东西, 因为牵扯到科学计算问题, 比如对于
3×(1+5)
2+3×4
其运算顺序不是从左往右固定结合的. 为了方便的实现科学计算, 我们发明了前缀表达式.
2.2. 前缀表达式
又叫波兰表达式 (Polish Notation, PN) 因为是波兰数学家 Jan Łukasiewicz 发明的.
定义: 如果运算符是在前面放着那么叫前缀表达式. 比如上面刚才举得两个例子重写一遍就是
× 3 + 1 5    //可以理解为 MUL(3,ADD(1,5))
+ 2 × 3 4    //可以理解为 ADD(2,MUL(3,4))
好处是不用管运算顺序了, 因为前缀表达式只有一种可能的结合顺序, 计算机也很方便读, 因为根据操作符进行压弹栈和相应运算就行了. 本质是将符号计算表达式写成了树的结构, 便于递归和迭代.
课外知识:这种语法解析树经常被用在编译器前端后端之间的接口,称之为AST。而AST表达式可以作为中间语言IR连接编译器前后端。这样的好处是我们要开发国产语言就没必要开发整个编译器了,只需要开发前端,然后对接上后端的汇编器,连接器,就能直接编译在x86或者arm上跑我们的程序了,而无需研究乱七八糟的指令集汇编器。同理,我们的处理器也只需要实现后端,就能直接把别人的程序编译到我们的中国芯片上。
所以针对任何公式, 计算机要运算一般都是根据规则先转化为前缀表达式然后才开始计算的.
比如 \(\int_1^8 x^2dx\) 就可以在Mathematica中转化为
Integrate[x^2,{x,1,8}]2.3. λ函数的定义
我先不说λ演算, 让我们先回忆一下高等数学这个大家都学过的东西里的函数的概念, 对应一下. 然后介绍λ函数, 注意是lambda函数, 不是lambda演算. 因为很多教程一下子弄太快人会懵逼的, 我们还是一步步来. λ函数表达式是咱常见的表达式的另一种写法, 对理解lambda演算有帮助.
λ函数包括以下元素:
- 变量 Variable : 值得注意的是变量可以是任何东西, 可以是函数, 可以是其他变量, 可以是字符串, 可以是数…….
- 函数 Function : 函数有两个部分, 参数(parameter, 或者叫头部head)和函数体(body). 当然λ里的函数的样子还是和普通的有区别的.
- 应用 Application : 将变量应用到函数中, 就称这个操作为应用.
举个例子:
\[\begin{align} f(\color{green}{x},\color{green}{y})&=x^2+y^2\tag{1}\\ \color{blue}{f(2,5)}&\color{blue}{=2^2+5^2=29}\tag{2}\end{align}\]
其中 \(\color{green}{\text{绿色部分}}\) 就是参数, 第一行整个是函数, 第二行 \(\color{blue}{整个}\) 是函数的应用.
很好理解吧.
举例:
\[\begin{align} \color{red}{\lambda}\color{green}{x}\color{red}{\lambda}\color{green}{y}&.x^2+y^2\tag{1}\\ (\color{red}{\lambda}\color{green}{x}\color{red}{\lambda}\color{green}{y}&.x^2+y^2)(2,5)\tag{2}\\ &=2^2+5^2=29 \end{align}\]
类比一下, \(\color{red}{\text{红色部分}}\)是λ符号, 没有任何特殊意义, 只是代表接下来跟随的 \(\color{green}{\text{绿色部分}}\) 是参数, 而点号”. “分隔了参数和函数体.
函数的应用, 也就是具体的值带入的话方法和原来常见的函数带入方法其实一样, 把具体的东西按顺序带入到变量即可. 本质其实就成了字符串替换一样的操作.
使用括号控制结合和语法拆分方式(默认是左结合的, 也就是从左边向右算, 和普通的计算式没什么区别.)
所以, λ函数是一种典型的前缀表达式写法, 这也就是为什么这东西比传统函数好用.
λ函数还有个优点就是变量明确. 比如对于 \(y=x^2+2x+1\) , 可以看作 \(f(x)=x^2+2x+1\) , 也可以看作 \(g(x+1)=(x+1)^2\) . 那么到底 \(y\) 是关于谁的函数? \(x\) 还是 \(x+1\) ? 歧义!尤其是高考,最爱考这种莫名其妙的没有任何用处的定义,去恶心人(因为我最近恰巧正在辅导一个高中生的数学)。 λ函数因为明确声明了变量, 所以不存在歧义. (由λ, 点号隔开了).
知识点: λ函数可以将整个整体看作一个对象, 也就是说本身可以当作变量塞到另一个函数里头.
比如
\[\begin{align} &(\color{red}{\lambda}\color{green}{x}\color{red}{\lambda}\color{green}{y}.xy)(\color{red}{\lambda}\color{green}{a}.ac)(f)\\ =&(\color{red}{\lambda}\color{green}{a}.ac)(f)\\ =&fc \end{align}\]
现在很多语言都支持匿名函数这个东西, 其实就是一种lambda函数. 比如Python的匿名函数.
用法举例:
(lambda x,y: (x+y)**2)(1,2)
>>> 9
支持拿匿名函数赋给对象
f = lambda x,y: (x+y)**2
f(1,2)
>>> 9
还算易于理解吧?
记住这个匿名函数”赋值”, 因为这实际上可以理解为一种宏, 也就是拿一个短一点的东西替代一大片东西.后面会用到.
2.4. λ演算的定义
定义: λ演算是一套从数学逻辑中发展, 以变量绑定和替换的规则, 来研究函数如何抽象化定义, 函数如何被应用以及递归的形式系统.
λ演算和lambda函数包括的元素是一样的:
- 变量 Variable : 值得注意的是变量可以是任何东西, 可以是函数, 可以是其他变量, 可以是字符串, 可以是数…….但是严格来讲, λ演算只有函数和参数这一种数据类型 , 不存在数字, 字符串, 数组等乱七八糟的其他东西, ……..你从哪学的什么面向对象, 堆栈, 数据结构, 指针? 忘了它们! 我们的λ演算非常的数学式简洁.
- 函数 Function : 函数有两个部分, 参数(parameter)和函数体(body).
- 应用 Application : 将变量应用到函数中, 就称这个操作为应用.
注意, 严格的λ函数是没有除了函数之外的任何东西的, 函数就是构成lambda演算的所有东西! lambda函数既是函数, 同时也是变量, λ演算的函数可以作为算法的一部分, 也可以作为数据的一部分, 全看你怎么解析!
古人云, 数据和程序不分家, 果然如此. 在传统图灵机里, 程序和算法都可以是01二进制数字, 在计算机里, 无非就是高低电平罢了.
在λ演算里, 高低电平变成了函数. 真抽象………所以这东西现实中压根没有类比的事物. 所有λ函数构成的空间就是λ演算所能有的所有集合.
那么连数字都不存在, 这个”函数”怎么计算东西呢?
答: 其实压根不必在乎数字的形式, 对于他们来说, 这只是一种表达方法罢了. 用
0 1 2 3 4 5 6 7 8 9 表示数字, 和使用
0  1    //二进制
a b c d e f ......
!  @  #  $  %  ^  ......
甲乙丙丁戊己庚辛.....
没有任何区别. 稍后将介绍定义”数字”的方法, 然后来看看λ演算里的奇葩数字表示方法.
2.5. λ演算的操作
和λ函数类似, 只不过不存在传统数字, 而且同理, 也不存在传统算符.
知识点: λ演算本质是字符串替换.
怎么理解呢? 举个例子, 其实就是刚才的
\[\begin{align} &(\color{red}{\lambda}\color{green}{x}\color{red}{\lambda}\color{green}{y}.xy)(\color{red}{\lambda}\color{green}{a}.ac)(f)\\ =&(\color{red}{\lambda}\color{green}{a}.ac)(f)\\ =&fc \end{align}\]
在λ函数里, 我没提这个概念, 那么你完全可以按照普通的方法解析这个函数, 将字母间认为是乘积关系就可以.
但是在λ演算里, 由于不存在算符, 那么就不能将他们看作多个变量的乘积了, 你可以暂时就认为他们是一个有序的字符串即可. 当然之所以是暂时, 是因为这实际上不是字符串, 它就是变量, 或者称之为一种符号, 到后面你会理解这个东西的含义的. 我最开始学这个的时候一头雾水, 直到后面才恍然大悟. 在此之前, 先就认为是类似于正则表达式之类的匹配加替换吧.
有时候, 也会给每个参数的声明处添加一个点作为结尾
\[(\color{red}{\lambda}\color{green}{x}.\color{red}{\lambda}\color{green}{y}.xy)(\color{red}{\lambda}\color{green}{a}.ac)(f)\]
lambda这个希腊字母符号可以拆分多个变量, 比如起名字可以任性点
\[(\color{red}{\lambda}\color{green}{ngc}\color{red}{\lambda}\color{green}{13009}.ngc\space13009)(\color{red}{\lambda}\color{green}{x}.x\space t)(funny)\]
无妨, 因为λ表达式的优越性, 不必担心歧义问题.
还有就是因为lambda演算没有传统的数字表达, 那么你完全可以把普通数字作为变量或者参数.
知识点: λ演算中只有 “λ” ” . ” “(” “)” ” , “五种符号是保留符号(空格和”,”等效,仅作为参数分隔符), 具有预定义的含义. 其他键盘上或者你能画出来的符号, 随便用. 都可以作为lambda演算里仅有的数据类型: 变量.
定义: λ演算, 可以使用宏去简化写法. (macro)
学计算机的都知道, 应用宏可以方便的避免重复写太多相同的代码, 而且便于调用. 比如如果我们经常看见以下表达式, 那么完全可以使用某个约定的记号统一替换下文, 应用的时候只需要替换就行了. 宏可以在全局开始的时候声明, 告诉解释器或者阅读的人. 本文就用类似于这个记号表示一个宏的声明
\[\color{blue}{T}= \color{red}{\lambda}\color{green}{x}\color{red}{\lambda}\color{green}{y}.x\]
\(\color{blue}{蓝色的}\) 部分就是作为宏的部分. 因为λ演算不存在赋值或者相等符号, 所以用等号没有歧义.
定义:如果lambda演算的传入参数不够(比如缺少传入参数或者传入参数为0), 那么优先处理左侧的参数, 没有的就保留, 不做替换. 比如
\[\begin{align}( &\color{red}{\lambda}\color{green}{x}\color{red}{\lambda}\color{green}{y}.x) (a)\\ =&\color{red}{\lambda}\color{green}{y}.a \end{align}\]
现在介绍λ演算的三个规则, 其实也就三个规则.
按道理此处应该使用三级标题, 但是因为知乎不支持, 所以仅编号使用三级标题了….
另外, 前面的公式上色只是为了好看便于区分……
注意lambda函数在字符替换的时候,不同层级的函数的字符是不能替换的,只能替换相同运算层级的函数符号(本文中,我尽量用括号明确了运算层级,其实一些括号可以省略。但是大家都是初学者,写上会清楚些)
2.5.1. α变换
对于形如 \(\lambda x.t\) 的 lambda 项, 可以将 \(x\) 替换为其他标识符, 同时将 \(t\) 中的所有 \(x\) 同样替换.
例如, 对于 \(\lambda a.a\) , 可以简单的把\(a\) 换成 \(b\) , 得到 \(\lambda b.b\) .
但要注意一些边界, 例如 \(\lambda x.(\lambda x.x)x\) , 将最外层的 \(x\) 替换成 \(y\) 时, 得到的是 \(\lambda y.(\lambda x.x)y\) , 而 \(\color{red}{\text{不是 }λy.(λy.y) y}\) .
换而言之就是保证拓扑关系不变, 或者逻辑关系不变.
举例:
\[\begin{align} &(\color{red}{\lambda}\color{green}{x}.\color{red}{\lambda}\color{green}{y}.xy)(\color{red}{\lambda}\color{green}{a}.ac)(f) \\ =&(\color{red}{\lambda}\color{green}{ngc}\color{red}{\lambda}\color{green}{13009}.ngc\space13009)(\color{red}{\lambda}\color{green}{x}.x\space t)(funny) \end{align}\]
2.5.2. β规约(化简)
其实就是上面的函数带值. 或者叫字符串替换….但是λ演算的β规约其实和这些都不一样, 因为其规约的可以是任何λ演算的元素(虽然也就那几种元素).
需要注意规约的顺序. 自左向右, 先算括号(本一轮规约时括号内当作整体).
举例:
\[\begin{align} &(\lambda x.(\lambda y.y)x)z\\ =&(\lambda y.y)z\end{align}\]
不建议在有语义冲突的时候进行规约, 应该先替换变量的标识. (毕竟人和计算机还是需要标识才能区分对象的)
正确示范: (基于α变换前提: 标签可以统一更换)
\[\begin{align} &(\lambda a\lambda b.a\space b)\color{blue}{b}\\ =&(\lambda a\lambda b.a\space b)\color{blue}{t}\\ =&\lambda b.\color{blue}{t}\space b \end{align}\]
错误示范:
\[\begin{align} &(\lambda a\lambda b.a\space b)\color{}{b}\\ =&(\lambda b.b\space b)\color{blue}{}\tag{×}\\ =&??? \end{align}\]
2.5.3. η变换
一个显然的变换
\[(\lambda a.x)t=x\]
可以容易的发现, 其实三个规则都是一个规则, 就是正常的, 逻辑上的类似于函数带入数值, 或者所谓的字符串替换.
2.6. λ演算的等价关系定义
定义: 若有两个λ演算的表达式 \(x\) 和 \(y\) , 如果通过三种变换能从\(x\) 到 \(y\) ,那么称\(x\) 等价 \(y\) .
性质:
- 自反性: 对于 lambda 项 x, 都有 x 等于 x.
- 对称性: 对于 lambda 项 x,y, 若 x 等于 y, 则一定有 y 等于 x.
- 传递性: 对于 lambda 项 x,y,z, 若有 x 等于 y, y 等于 z, 则一定有 x 等于 z.
证明留做习题.
2.7. 为啥是λ?
有人可能好奇这个字母的来历.
偶然因素。也许一开始邱奇画了一个顶部符号上去,像这样:(ŷ xy) ab。在手稿中,他写成了这样(⋀y.xy) ab。最后排字工人,把它变成了这样(λy.xy) ab。
一次排版的粗心事件罢了.
2.8. 一些其他表示
有时候, 我们默认参数是由一个字母构成的, 那么为了方便自己输入排版 (反之的, 阅读者就更难阅读了), 有如下等价表示,
举例: \(\lambda x\lambda y.x\space y\Leftrightarrow \lambda xy.xy\) 当然我是不推荐这么写的, 因为容易混淆. 而且大家都是习惯把字母挤在一起代表乘法, 这种参数共享一个λ, 变量之间没空格的…………不好. 不建议.
3. λ演算的图灵完备性
好活开始了!
λ演算的特色就是, 函数在这里, 但是它什么都不计算, 它就是一个表达式而已, 你唯一能对它进行的操作就是解析它, 把它从一个模式变为另一个模式, 不断迭代(可能永远不会停止).
但是通过巧妙的定义一些特定的λ表达式, 我们可以用这个东西代替任何算法! 如果λ演算没有需要的东西, 那么就拿我们手头有的东西构造它.
当然你也可以拿λ演算做普通的计算, 但是这就像拿高压锅炒菜, 一点都不优雅.
还是优雅一点好.
注意在后文的Python实现中, 还有一点点原理性的知识点, 所以这两个部分要一起看完才算完整.
让我们先从布尔代数开始吧. 布尔代数仅有两个值, 真值与假值, 比较方便, 基础运算也少. 是一个良好的切入点.
3.1. IF分支,True和False
定义:不妨定义:
\[T=\lambda x.\lambda y.x\]
\[F=\lambda x.\lambda y.y\]
然后定义: \(IF=\lambda b\lambda t\lambda f.b\space t\space f\) (约等于什么都没做, 只是将三个参数用类似于字符串操作拼接到一起)
至于为什么这么定义?
考虑一个实际场景, 比如如下代码
if(condition):
    code1
else:
    code2
如果定义T, F, 和IF如上的话, 那么你看看, 刚好!
如果condition为True, 相当于:
\[\begin{align} &(\lambda b\lambda t\lambda f.b\space t\space f)(\lambda x\lambda y.x)c1,c2\\ =&(\lambda x\lambda y.x)c1,c2\\ =&c1\\ \end{align}\]
如果condition为False, 相当于:
\[\begin{align} &(\lambda b\lambda t\lambda f.b\space t\space f)(\lambda x\lambda y.y)c1,c2\\ =&(\lambda x\lambda y.y)c1,c2\\ =&c2\\ \end{align}\]
完美实现了IF的分支结构和真假值的功能.
如果一个东西看起来像鸭子, 叫起来像鸭子, 听起来像鸭子, 吃起来像鸭肉, 那么它就是鸭子!
3.2. 逻辑运算
定义:如下基本逻辑运算符
\[a \, \text{AND} \, b=\lambda a\lambda b.IF\, a \,b \,F\]
\[a \, \text{OR} \, b=\lambda a\lambda b.IF \,a \,T \,b\]
\[\text{NOT} \, a=\lambda a.IF\, a\, F\, T\]
注意: \(IF\, a \, b \, c\) , 根据左结合原则, 实质上是在说 \(IF((a \, b) \, c)\)
演算一下? (下面公式的一些括号只是为了方便阅读, 实际中可以不需要一些括号, 只要不引起歧义就可以)
\[\begin{align} &a \text{ AND }b\\ =&(\lambda a\lambda b.IF\,a\,b\,F)\\ =&(\lambda a\lambda b.(\lambda u\lambda t\lambda f.u\,t\,f)a\,b\,F)\\ =&\lambda a\lambda b.a\,b\,F\\ \text{if a=T, b=T,}\\ =&(\lambda a\lambda b.a\,b\,F)\lambda x\lambda y.x\,\,\,\lambda x\lambda y.x\\ =&(\lambda x\lambda y.x)\lambda x\lambda y.x,\lambda x\lambda y.y\\ =&\lambda x\lambda y.x\\ =&True\\ \text{if a=T, b=F,}\\ =&(\lambda a\lambda b.a\,b\,F)\lambda x\lambda y.x\,\,\,\lambda x\lambda y.y\\ =&(\lambda x\lambda y.x)\lambda x\lambda y.y,\lambda x\lambda y.y\\ =&\lambda x\lambda y.y\\ =&False\\ &\dots \end{align}\]
其他的自行验证吧. 留 做 习 题 .
3.3. 跳转分支
既然是图灵完备的, 那么λ演算肯定也有类似于分支跳转的东西.
λ演算的分支跳转实际上应该实现一个迭代多次之后, 主体结构保持不变, 然后一小部分在变化, 直到化简完毕就相当于退出分支了, 进入停机.
一个简单的死循环: \(\lambda x.x\) 显然它会一直等待参数, 所以迭代的结果就是其自身(根据上面提到的规则: 如果参数不够则只处理目前有的参数, 显然现在没有参数), 非常类似于汇编的JMP $的用法.
基本思路: 通过循环+IF判断的方法就可以构造任意跳转了.
定义:while循环: \(while\,n\,f=\lambda n.f\)(这里定义似乎有问题, 稍后修改)
3.4. 数字
程序分支问题解决了, 该处理数字了.
前文已经实现了一个图灵机所应具备的最小功能: 分支跳转, 条件判断, 赋值. 那么只要λ演算能处理数字的话, λ演算就是图灵完备的了! 可以实现任何功能. 这是基于图灵完备定理推导的结论.
定义: 不妨定义: \(n=\lambda f.f^n\) 其中 \(n\) 处于类似于”次幂”的角标位置, 这里肯定不是次方运算, 更类似于”嵌套函数的嵌套层数”.比如 \(f^3a=f(f(f a))\) 这样子我们直接定义了所有自然数:
\[\begin{align} 0&=\lambda f\lambda x.x\\ 1&=\lambda f\lambda x.f\,x\\ 2&=\lambda f\lambda x.f(f\,x)\\ 3&=\lambda f\lambda x.f(f(f\,x))\\ &\dots \end{align}\]
有人会问: 这tm是数字? 这可一点都不像是传统数字.
那么我们考虑, 数字是干嘛的? 显然, 数字是用来计数的. 至于它的具体形态, 无关紧要
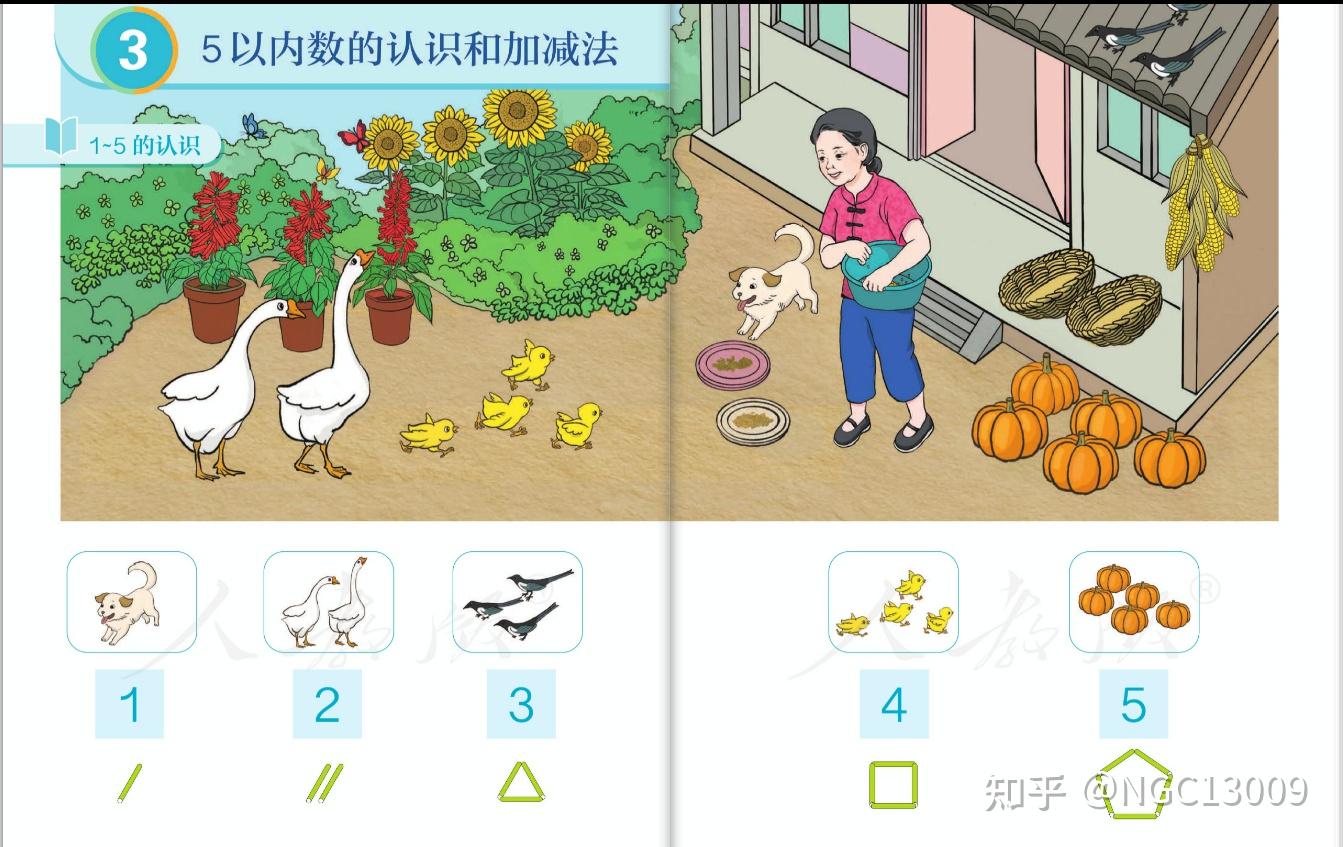
这是人教版重绘插图的一年级上册数学课本. 其中枚举了三种数字的表示方法, 加上刚才说的λ演算:
- 具体的事物的个数
- 阿拉伯数字
- 火柴
- λ演算
本质上, 只要用来计数的东西满足几个条件之后, 就可以用这种东西来计数. 其实这几个条件在高等代数还是抽象代数里讨论过.
为了定义一个合理的基数, 我们需要它有以下性质:
能作为计数用的东西的性质:
- 单值性: 每个数字都不是相同大小的
- 可连续映射性: 没有数字的时候, 我们比较东西的多少可以通过将两组东西一一配对, 看谁最后剩下. 同理, 其实用”数字”计数的时候也是在拿数字和被计数的东西一一配对然后丢弃刚才的缓存结果. 这和原始人比较苹果和梨的多少的方法一致.
- 后继性: 每个数字都应该有比其大一个单位的数字
- 良序性: 就是能比大小
注意上面性质的第二个的表述: 这其实是定义计数是在干什么的.
3.4.1. 关于后继运算的介绍
大部分人以为加法就是最基础的运算了, 其实不是. 最基础的运算是后继运算. 后继运算接收一个参数, 输出这个参数的下一个参数(因为参数具有良序性. 没有良序性就没有后继运算). \(S(n)=n+1\) 这个就是后继运算. 其实各类编程语言, 比如c/c++里对于变量i的++i操作就是后继操作.
后继运算的高阶运算是加法运算. 相当于迭代后继运算.
同理, 加法的迭代运算就是乘法…….能一直排下去. 数学最喜欢套娃了, 因为套娃的东西往往具有共性.
3.5. 后继运算
λ演算中的数, 虽然定义的看起来一点都不像数字 (尤其是函数作为一个基底用来计数, 简直太怪了…….还是见得少了, 数学中能做基底的多着呢), 但是却真真切切的属于计数的一种, 因为它有后继运算.
定义:λ演算中的后继运算被定义为 \(S=\lambda n\lambda f\lambda x.f(n\,f\,x)\) 你把这个东西带入数字算一下: (拿++1=2举例)
\[\begin{align} S(1)=&S \,\lambda f\lambda x.f\,x\\ =&(\lambda n\lambda f\lambda x.f(n\,f\,x))\lambda f\lambda x.f\,x\\ =&\lambda f\lambda x.f((\lambda f\lambda x.f\,x)f\,x)\\ =&\lambda f\lambda x.f(f\,x)\\ =&2 \end{align}\]
其他的自行作为课后习题演算.
同理,
3.6. 加法
定义: \(+=\lambda a\lambda b\lambda f\lambda x.a\,f(b\,f\,x)\) 注意这里加号只是一个普通的符号, 换而言之, 一个宏.
加号使用前缀表达式计算. 举例:
\[\begin{align} +\,1\,2&=(\lambda a\lambda b\lambda f\lambda x.a\,f(b\,f\,x))(1,2)\\ &=\lambda f\lambda x.1f(2fx)\\ &=\lambda f\lambda x.f(f(fx))\\ &=3 \end{align}\]
注意其中的数字123其实也是宏, 替换成刚才定义好的λ演算模样的计数.
同理, 可以定义乘法.
3.7. 乘法
定义: 如下: \(\times=\lambda a\lambda b\lambda c.a(b\,c)\) 举例: (虽然有三个参数, 但是实际应用的时候只给两个参数进行演算, 最后剩下的c自然的就变成了”数字”)
\[\begin{align} \times \,\,2\,\,3 &= (\lambda abc.a(bc)) (\lambda sz.s(s(z))) (\lambda xy.x(x(x(y))))\\ &= \lambda c.(\lambda sz.s(s(z)))((\lambda xy.x(x(x(y))))c)\\ &= \lambda cz.((\lambda xy.x(x(x(y))))c)(((\lambda xy.x(x(x(y))))c)(z)) \\ &= \lambda cz.(\lambda y.c(c(c(y)))) (c(c(c(z)))) \\ &= \lambda cz.c(c(c(c(c(c(z)))))) \\ &= 6 \end{align}\]
头大………
3.8. 减法
减法的定义的推导很难, 直接发明减法太难的话, 不如考虑已知n, 然后从0数到n-1, 就定义了反后继, 进而减法就可以定义了.
推导过程略.
定义:减法:
\[\begin{aligned}-=\lambda x\lambda y.y(\lambda n.(\lambda p.p(F))(n(\lambda p. (\lambda a\lambda b.(\lambda s.s(a)(b)))(\lambda n\lambda f\lambda x.f(n(f)(x))((\lambda p.p(T))(p)))((\lambda p.p(T)))(p)))((\lambda a\lambda b.(\lambda s.s(a)(b)))(0)(0))))(x)\end{aligned}\]
这个不是最简式, 化简留给大家.
推导过程在后文的Python实现部分. 因为写文章的时候是顺着参考文献写的, 等写完了才发现把解释写错地方了…… 算求了懒得搬了, 移步后文吧.
3.9. 乘方
lambda演算的乘方实现很简单, 就是将一个数自乘多次即可.
定义: 乘方 \(a^b=\lambda a\lambda b.b(a)\) . 感觉很奇怪, 其实将a和b带入具体的数字即可.
3.10. Y组合子
这个东西是lambda演算图灵完备性的关键。一个东西只要能实现顺序,分支,循环,就可以图灵完备。顺序和分支上面已经解决了,而Y组合子解决的是循环。事实上,lambda演算中没有循环,我们通过循环的等价形式:递归,来实现这个功能。
Y组合子的基本原理是:通过函数不动点,返回函数的递归嵌套形式,然后配合选择分支,就能完成递归计算等价循环了。而无需使用命名的方式自己调用自己。
定义: 不动点: 一个函数的不动点, 指的是这个函数存在以下关系 \(\displaystyle x=f(x)\) 时的 \(x\) , 称为 \(f\) 的一个不动点.
相似的, 推广一下, 对于任何映射 \(f:A\to B\) , 如果 \(A=B\) 且针对一个元素 \(x\in A\) , 存在 \(f(x)=x\in B\) , 那么 \(x\) 是映射 \(f\) 上的一个不动点.
\(x\) 当然可以是函数! 也可以是lambda表达式.
然后尝试一下计算不动点, 假设存在这样一个函数, 对于某种集合存在的一种映射, 通过该函数可以找到不动点, 记该函数为 \(Y\) , 那么有 \(\displaystyle Y(g)=g(Y(g))\) . 通过 \(Y\) 就可以找到映射 \(f\) 中的不动点.这样,我们使用 \(Y(g)\) 作为函数整体,作用到一个变量上,它就会自动展开自己的递归。
定义: Y组合子: \(Y= \lambda f. ((\lambda x. (f(x x)) )(\lambda x. (f(x x))))\) . 这个就是lambda演算中著名的Y组合子. 经过简单演算可以证明是没问题的(需要你有较好的视力去确认括号的层级。。。):
\[\begin{align}Y(g)&= (\lambda f. ((\lambda \color{gray}{x}. (\color{blue}{f}(\color{#55aa55}{x}\color{#aa11bb}{ x})) )(\color{red}{\lambda x. (f(x x))})))(g)\tag{1}\\ &= (\lambda f.(\color{blue}{f}((\color{#55aa55}{\lambda x.(f(x x))})(\color{#aa11bb}{\lambda x.(f(x x))}))))(g)\tag{2}\\ &= g((\color{#55aa55}{\lambda x.(f(x x))})(\color{#aa11bb}{\lambda x.(f(x x))}))\tag{3}\\ &=\color{black}g(\color{#999900}{(\lambda x. (f(x x)) )(\lambda x. (f(x x)))})\tag{4}\\ &= g((\lambda \color{#00aaaa}{f}. (\color{#999900}{(\lambda x. (f(x x)) )(\lambda x. (f(x x)))}))(\color{#00aaaa}{g}))\tag{5}\\ &=g(Y(g))\tag{6}\\ \end{align}\]
我用颜色标注了代换方式:
- 第一行灰色的x首先被红色的部分应用,对应到了绿色和紫色的部分。而蓝色的部分从第一行到第二行位置没变。
- 第二行到第三行,将g应用到黑色的f上。
- 第三行到第四行,重新染色,用于区分符号。
- 第四行到第五行,事实上是逆运算。是不是假设运算顺序是第五行到第四行就能看懂了?我们通过合理的构造,将它逆运算回去,就能得到 \(Y(g)\) 的形式了。
- 第五行到第六行,等量代换。
注意lambda函数在字符替换的时候,不同层级的函数的字符是不能替换的,只能替换相同运算层级的函数符号(我用括号明确了运算层级,其实一些括号可以省略。但是大家都是初学者,写上会清楚些)。
Y组合子有什么用?
答:它是函数式编程的理论基础, lambda演算的一部分, 而并非一个“实用”的东西, 它只是lambda演算要实现逻辑的完备而产生出来的一个”工具”. 通过lambda的Y组合子,我们无需语法本身支持函数命名,就能完成函数递归调用自身。
这一点很重要。比如我们有个递归函数希望它实现循环相加(此处用Python语法表示一下)
# 先让我们忽略一下其中的if和数字。
# 事实上后面我会使用Python的lambda演算完全构造数字和判断分支,如同前文
# 但是此处为了方便理解,我们就先这么写。
# 读者可以在脑海里展开一下 if 分支和数字,加法等的lambda表达式,其实是一样的。
sum = lambda x : 1 if x <= 1 else sum(x - 1) + x
这个匿名函数定义为求和,即 \(\displaystyle s(x)=\sum_{i=1}^x i\) 。但是有个问题,lambda演算本身不能给函数命名,这不是lambda演算中定义的东西。而”宏“,应该是在编译阶段确定的,而非运行阶段。也就是说,这种写法不是lambda演算的运行时。因为传入参数是变化的,然而运行时不能给lambda演算提供任何除了函数以外的东西。显然此处函数的名称”sum“是个额外的东西。运行的时候不能存在任何除了lambda演算以外的东西!
我们必须构造一个函数,使之可以在运行时自动展开递归,但是不能出现任何符号表示其自身,只能用lambda演算的那几个基本东西。万物皆函数,怎么能给函数起名字呢?所以这种自己调用自己的方式是非法的。
但是有了Y组合子之后,我们就可以通过结合Y组合子,来实现函数调用返回自身了。并且不需要给函数起名字。
Y组合子是用作给那些没有名字的函数”把自己给算出来, 方便自己调用自己”而创造的.
理解困难? 没关系, 其实我也看的稀里糊涂, 而且是真的佩服第一个发现这个东西的人.
推荐这篇文章:写的非常清楚。如果你好奇Y组合子的基本原理,那么这个文章会告诉你,我们为了实现任意次数的递归,为什么需要找到Y组合子的这个形式,这个形式到底作用是什么?其实就是展开无限次函数的递归,类似于图灵机的Quine。
纸木城:Y组合子(Y Combinator)| The Little Schemer 第九章
3.11. Z组合子
(待完善内容,请等待更新)
Y组合子可以解决函数递归调用。但是假如我的传入参数不止一个,怎么办?
所以有了Z组合子。
z组合子通过将多个参数的函数柯里化(carrying)成一个单一参数的递归函数形式,然后使用Y组合子的思想,即可。
柯里化:
z组合子:
Yul8ulY:Y, Z and Simply Typed Lambda Calculus
3.12. 其他运算
都可以定义, 没有什么不能定义的.
留做习题, 看看谁能定义出来计算离散微分的符号函数?
其实上面这些东西, 已经能根据图灵完备定理证明λ演算是图灵完备的了.
4. λ演算的学习路线
自己学了一遍才发现, 这东西, 要做个编译器, 解释器, 很容易.
但是拿来写程序, 太难了.
λ演算大道至简, 没有乱七八糟的东西(比如面向对象, 指针, 内存空间, 泛型, 模板, 数组, 数据结构……), λ演算是一种面向函数的编程方法.
λ演算的基础规则很简单, 定义很简洁, 给人一种最接近数学但是最远离计算机的感觉.
综合来讲, 可以一个早上学习λ演算的概念和发展史, 一个下午学习λ演算的常见定义和基础操作(比如数字, 逻辑值的定义, 以及加减法等基础操作)
然后第二天熟读背诵第一天所学的知识, 便于熟练应用.
然后接下来的数年, 一起学习宏定义的用法……..(因为λ演算的所有东西都是宏定义封装)
顺便一提, λ演算既然图灵完备, 那么必然是自举的(可以自己编译自己, 同时必然可以设计编译器将其转化为其他语言, 反之, 也可以设计编译器把其他现成的代码编译成λ演算公式)
我记得华为不是就在研究方舟编译器, 怎么把安卓的字节码转移到鸿蒙上运行. 一个道理. 只不过实际上做起来很复杂.
5. Python上实现lambda演算
Presentation: Lambda Calculus from the Ground Up | PyCon 2019 in Cleveland, Ohio (python.org)
参考这个网站上的介绍, 现在给出Python实现lambda演算的方法.
Python自带了lambda表达式, 类似于lambda演算的形式去定义函数. 由于一般情况下不需要实例化函数, 所以这种方法又被叫做匿名函数.
Python的lambda匿名函数本身并不支持lambda演算的诸多功能, 例如它自身必须实例化到具体的表达式中才能正常解析, 而无法存储单纯的函数化简的结果. 但是利用一些”特性”可以实现基于Python的lambda演算.
5.1. bool操作
定义布尔值
def TRUE(x):
    return lambda y: x

def FALSE(x):
    return lambda y: y
定义布尔运算
def NOT(x):
    return x(FALSE)(TRUE)

def AND(x):
    return lambda y: x(y)(x)

def OR(x):
    return lambda y: x(x)(y)
注意到上述函数定义形式当然可以写成lambda表达式的形式. 这样更加统一.
5.2. 数字
定义数字
ZERO = lambda f: lambda x: x
ONE = lambda f: lambda x: f(x)
TWO = lambda f: lambda x: f(f(x))
THREE = lambda f: lambda x: f(f(f(x)))
FOUR = lambda f: lambda x: f(f(f(f(x))))
# ...
定义一个辅助函数. 用来将最终的化简结果输出, 如果没有这个函数, 那么最终无法直观的看到规约后的lambda表达式, Python只会返回函数的地址, 像这样
>>>a
<function <lambda> at 0x000001538F157160>
但是如果定义一个函数, 使得能把lambda表达式转化为int数, 那么必定是极好的.
定义如下函数:
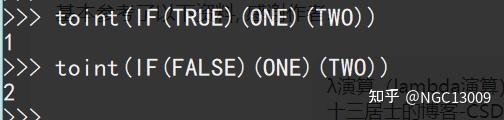
def toint(n):    # 注意该函数本身应该不属于lambda演算的一部分, 它只是一个辅助函数
    return n(lambda x: x + 1)(0)
就可以像这样:
>>> toint(THREE)
3
5.3. 后继
SUCC = lambda n: lambda f: lambda x: f(n(f)(x))Python里没有宏的概念, 该表达式实际上是将lambda表达式起了个名字, 将该名字指向了这个函数的入口. 但是这其实类似于实现了一个宏. 如果你是Python解释器, 那么你在运行到这一行的时候应该将这个lambda匿名函数实例化为一串代码并缓存到堆栈中, 然后创建一个符号并指向这个入口地址, 运行时根据符号指针确定运行哪个代码. (几年前学的稍有遗忘, 如果有不恰当表述请评论区指出). 如果你是人类, 那么直接进行字符串替换即可.
5.4. 加法
有了SUCC就可以实现加法了, 实质是在x上再后继y次.
ADD = lambda x: lambda y: y(SUCC)(x)5.5. 乘法
MUL = lambda x: lambda y: lambda f: y(x(f))5.6. 二元组
lambda演算的”前继”类似于从0数到n-1, 来实现n–的功能.
为了实现减法, 需要先实现二元组: 一种这样的操作: 接收两个参数并构成一个二元组数据结构, 通过特定的方法去操作二元组可以选择左值或右值.
CONS = lambda a: lambda b: (lambda s: s(a)(b))
CAR = lambda p: p(TRUE)
CDR = lambda p: p(FALSE)
举个例子
>>> p = CONS(2)(3)   # 构造二元组
>>> CAR(p)          # 取左值
2
>>> CDR(p)          # 取右值
3
5.7. 乘方
根据上面推导的过程, 乘方自然很容易实现
POW = lambda a: lambda b : b(a)5.7. 前继
下面借助二元组来实现一个数的前继. 我们可以从 (0, 0) 开始增加,(1, 0), (2, 1) …… 二元组的第二个数是第一个数的前驱, 而第一个数就是增加的次数.
T = lambda p: CONS(SUCC(CAR(p)))(CAR(p))然后定义前继
PRED = lambda n: CDR(n(T)(CONS(ZERO)(ZERO)))5.8. 减法
SUB = lambda x: lambda y: y(PRED)(x)5.9. 分支跳转
上文中已经方便的实现了类似于if的功能, 用Python写出来是这个样子:
IF = lambda b: lambda t : lambda f: (b)(t)(f)条件跳转类似于这样的效果:
但是条件跳转的条件如果是常量那么就失去意义了. 所以我们需要配套”是否等于”来实现一些功能. 只要实现了是否等于的判断, 就一并能实现判断大于, 判断小于等方法 (朴素的思想是: 两个一起往0减小, 谁先到0谁就小, 这里只考虑正整数).
让我们实现一个判断当前量是否等于0的宏:
ISZERO = lambda n: n(lambda _: FALSE)(TRUE)5.10. Y组合子
写代码:
Y = lambda f: (lambda g: f(g(g)))(lambda g: f(lambda y: g(g)(y)))Y组合子为lambda演算属于图灵完备表述的证明提供了有力的支持. (因为很多情况下lambda演算无法自己调用自己, 也就是在实现的时候, 宏的定义是不能包含自己的. 否则会发生递归错误, 毕竟大部分编译器会在编译阶段尝试展开所有宏定义, 甚至Python这种解释性语言也会在定义匿名函数的时候尝试展开(似乎被称作”惰性求值”的特性), 而在实例化之前的展开往往会产生无穷递归, 最终超过编译器的递归深度限制, 然后报错.
通过使用Y组合子重新表述这种引用自身的递归表达式, 可以实现包含递归情节的lambda表达式的书写.
举个例子: 使用递归来计算阶乘函数 \(\displaystyle FACT(n)=n!\) 的时候. 一般来说阶乘函数不会用递归写, 但是使用lambda演算的话, 递归形式反而是最方便的.
FACT = lambda n: ISZERO(n)(ONE)(MUL(n)(FACT(PRED(n)))) # 错误! 包含递归引用, 编译器无法正常运作使用Y组合子重新实现:
FACT = Y(lambda f: lambda n: L_ISZERO(n)(lambda: ONE)(lambda: MUL(n)(f(PRED(n))))) # 正确的或者这么写:
# 这里不绕弯了,直接清楚的写明白一个简单的递归阶乘
# 但是你仍旧可以尝试把他实现为一个完全的lambda表达式。事实上只需要把数字,判断分支,乘法减法换成上文提到的形式即可
factorial_non_recursive = lambda f: lambda n: 1 if n == 0 else n * f(n - 1)

# 然后应用 Y 组合子
factorial = Y(factorial_non_recursive)

print(factorial(5))  # 输出: 120
如果你认为这还不够lambda,那么我写了个完全lambda的递归函数,下面是它的代码(2024年9月25日)
foor = (lambda x,y :(((lambda c: ((lambda f: (lambda g: f(g(g)))(lambda g: f(lambda y: g(g)(y))))(lambda f: lambda n: (n > 0 and (f(n - 1), c(n - 1)))))))(x)(y)))这个函数基本等价于
def foor(func, count):
    for i in range(count):
        func(i)
这实际上实现了一个通用的循环结构lambda表达式。即任意循环都可以这么用。
说他“基本等价”是因为,实际上按理来说不应该有任何返回值,但是这个lambda会有一个很长的嵌套元组作为返回值。
6. 参考文献
基本参考了以下资料, 感谢作者.
λ演算(lambda演算)原理通俗易懂的详细总结_庵中十三居士的博客-CSDN博客_lambda演算
从零开始的 λ 演算 | weirane’s blog (ruo-chen.wang)
[完]